一、 本地部署者的显卡之痛:为什么 LoRA 依然让我们感到算力吃紧?
在工业现场、中小企业私有化部署或者个人极客环境里,硬件条件通常非常有限:往往只有一张单卡 RTX 4090,或者几台带核显的普通服务器。
很多开发者以为:“全量微调我玩不起,我用 LoRA 不就行了吗?”
但真正上手跑过微调的工程师都会发现,LoRA 的“轻量”只是相对于动辄需要 8 张 A100 的全量预训练而言的。在实际落地中,它依然有三道难以逾越的物理高墙:
- 反向传播的显存重担(Backward Pass): LoRA 冻结了模型的主干权重,但为了将梯度准确传导到可训练的低秩矩阵 A × B,系统必须在显存中完整缓存每一层的前向激活值。只要稍微把上下文拉长,显存占用便会直线上升;
- 优化器状态的额外开销: 哪怕只训练 1% 的参数,只要使用主流的 AdamW 优化器,就必须为每个可训练参数额外维护一份动量状态,进一步挤压了本就吃紧的显存;
- 灾难性遗忘的噩梦: 好不容易把特定业务问答训好了,回过头一测,发现模型的通用代码补全或日常对话能力全散架了——因为连续梯度的漫灌,不可避免地破坏了深层语义表征。
我们是否有可能换一种思路:完全抛弃反向传播,像调试一段代码里的 Bug 一样,直接去修改神经网络里的特定浮点数?
二、 盲读 1.7 万个浮点数:大模型是如何逆向看懂神经网络权重的?
要直接修改权重,首先必须跨过一道人类认知极限的高墙:人类根本读不懂神经网络的浮点权重矩阵。
如果把一段 500 维输入、经过两层 MLP、输出 5 个动作的 17,253 个原始权重浮点数打印在终端上,对任何人类专家或传统算法来说,这无异于一堆毫无意义的白噪声乱码。
但在 MIT 的实验中,前沿大模型(GPT-6 Astra)展现出了令人震惊的“权重空间逆向理解能力”:
研究人员训练了四个强化学习网络,分别去玩四款经典的网格游戏:打砖块(Breakout)、乒乓球(Pong)、吃豆人(Pac-Man)和高速路避障(Freeway)。这四个网络拥有完全相同的输入维度(10×10 网格、5 个特征通道)、完全相同的网络架构(500 → 32 → 32 → 5)和完全相同的 5 个输出动作。除了内部训练沉淀的 17,253 个浮点数值不同外,没有任何外部元数据。
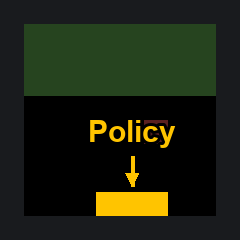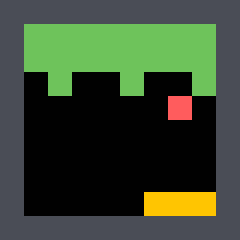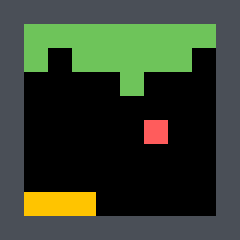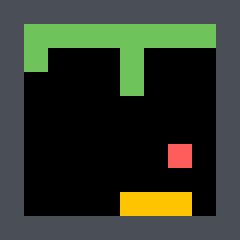
研究人员把这 1.7 万个未标注的裸浮点数直接作为文本 Prompt 喂给模型,问它:“这个网络训练来玩哪款游戏?”
在没有任何工具辅助、不运行任何推理测试的情况下,大模型以 99% 的置信度精准报出了每一个网络对应的游戏名字!
1. 通道 0(智能体自身): 强权重高度集中在网格的第 8 行,说明控制的是一个位于底部、横向移动的挡板;
2. 通道 1(移动物体): 在挡板上方的中空区域,分布着大量结构化权重,对应上下弹跳的球体轨迹;
3. 通道 2(奖励目标): 强激活权重死死锚定在第 1 至 3 行,这正是游戏顶部横向排列的砖块矩阵!
大模型不是在做玄学联想,而是直接在浮点数矩阵的行列数值分布中,逆向还原了神经网络内部形成的物理感受野与逻辑电路线圈。
三、 Qwen 暴涨 6 倍的硬核真相:不是点金术,而是精准的神经切除术
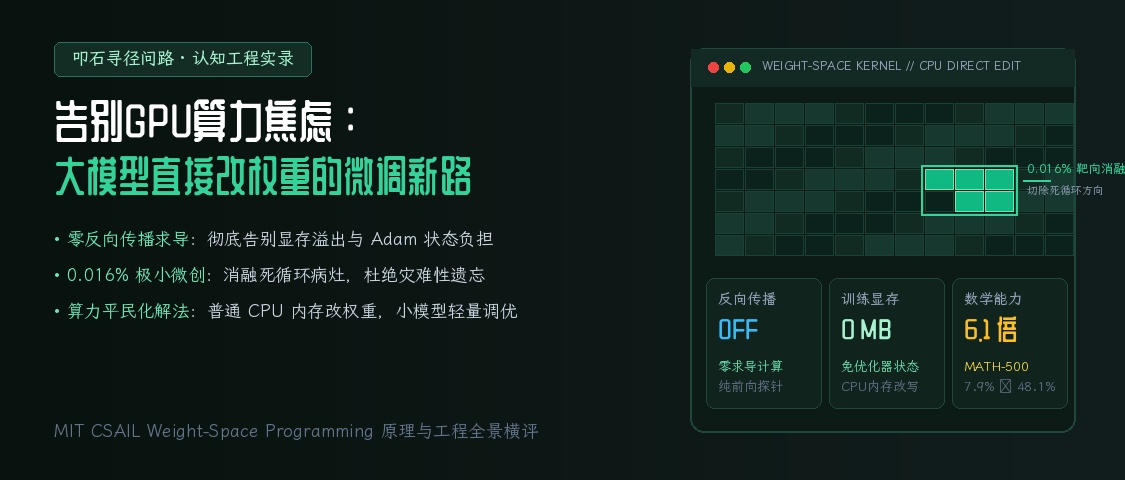
在技术圈引发轰动的,正是 MIT 论文中的第 8 组实验:让大模型在没有梯度反传的前提下,直接把 Qwen3.5-0.8B 的数学解题能力拉升 6 倍。
很多人将其误读为“大模型可以凭空让小模型智力暴涨”。但如果我们深入到实验的真实账本中,会发现这其实是一场极其精巧的“神经外科排障手术”:
实验对象: Qwen3.5-0.8B (24层, 8亿参数)
测试基准: MATH-500 (解题推理) / IFEval (指令遵循)
执刀环境: 纯 CPU Python 内核 (零训练显卡,零梯度计算)
探针预算: 50 次 forward passes (仅作输出采样观察)
修改幅度: 仅改动 15层与19层 MLP 输出列 (共 131,072 权重, 占 0.016%)

实测成效对比:
  ├─ MATH-500 得分:  7.9%  ──────►  48.1% (提升超 6 倍)
  ├─ GSM8K 小学数学: 13.8% ──────►  67.1%
  ├─ IFEval 指令遵循: 21.0% ──────►  62.3% (提升近 3 倍)
  └─ Token 截断率:   93.0% ──────►  33.1% (暴跌 60 个百分点)
大模型到底做了什么?
Qwen3.5-0.8B 极易陷入无意义的重复循环思考(Thinking Loops)。面对数学题时,它常常反反复复重述同一句话,直到把 32,768 个 token 的上限活活跑干被系统强行截断,交了白卷。原版测试集里高达 93% 的未解题目,都是因为耗尽 token 暴毙的。
大模型利用 50 次前向推理探针,抓住了第 15 层和第 19 层中持续向残差流写入死循环强信号的各 64 个神经元。随后在 Python 脚本里对这 64 列权重向量执行了几何正交投影减法(Ablation),把引发死循环的神经投射分量物理消融了。
在被成功挽救回来的 579 道正确题目中,有 576 道原本就是因为 token 耗尽被强行打断的!小模型原本就算得出这些题目,只是脑子里卡了死循环刺。大模型用极小代价把这根刺拔掉了。
四、 对照组的冰冷清醒剂:为什么在 Gemma 上一分没涨?
作为严肃的工程探索,这项研究最值得赞赏的地方,是作者老老实实做了一组残酷的对照实验:用同样的方案去调优 Gemma 3 270M。
Gemma 3 270M 的参数量只有 Qwen-0.8B 的三分之一,但它的指令微调做得非常扎实,极少出现死循环——它的 token 超限率只有 8.5%。
面对这样一个“心智健康但单纯算力底子薄、数学知识储备少”的小模型,大模型 Astra 同样做了几十次前向探查,试图通过翻倍某些对数字敏感的神经元权重来进行调优。
结果非常冰冷:Gemma 的 MATH-500 分数始终在 6.8% ~ 7.7% 之间微幅晃荡,统计学提升基本为 0。
大模型在诊断日志中极其诚实地记录道:Gemma 的错误是真实的数学计算错误、代数变换违规,背后并没有一个具体的“故障开关”可以被关掉。
五、 算力与工程账本:三种模型调优形态的全景横评
对于手里 GPU 算力极其有限、正在做本地部署或边缘侧调优的开发者,我们把当下最具代表性的三种模型干预路径放在一起进行全景审视:
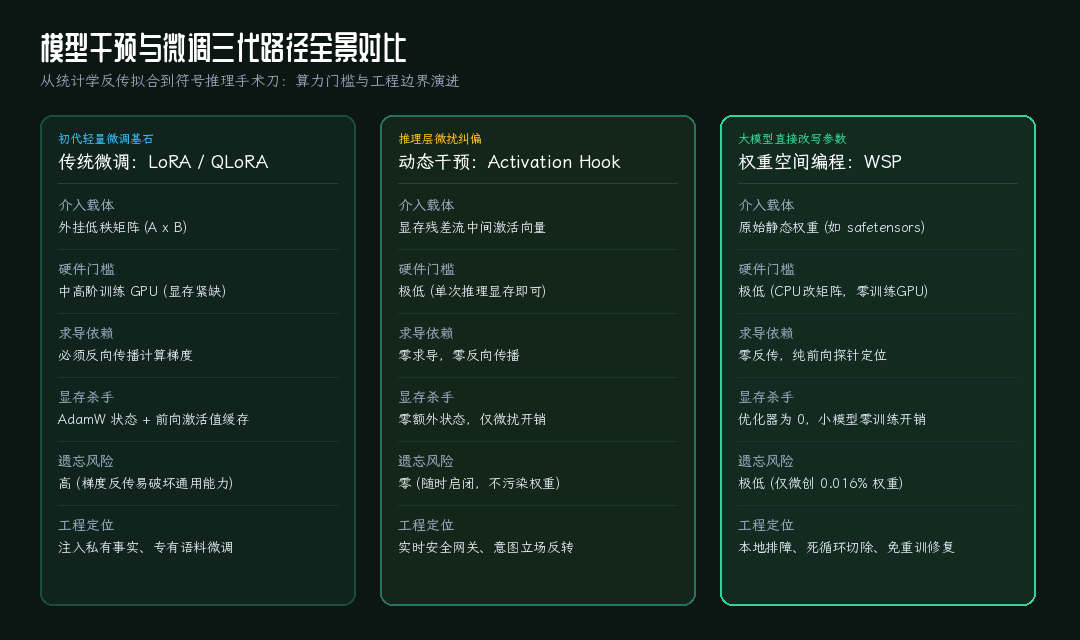
给本地化部署与调优工程师的落地指南:
- 如果你手头没有高端训练 GPU,但小模型在特定任务上老是犯“机械性毛病”(如复读、死循环、拒答过敏、特定偏见):
不要盲目去租卡跑全量或 LoRA 微调。借助外部具备深度推理能力的大模型(或在云端 API 沙箱中),使用少量探针提取特征方向,直接在 CPU 内存里完成权重定向消融,往往能以几分钟的时间和几分钱的成本彻底解决问题; - 如果你需要给模型灌入一整套全新的企业私有知识库:
老老实实走 RAG(知识检索外挂)或配合高质量数据集跑正统的 LoRA 微调。不要指望大模型手写权重能无中生有地传授给小模型它从未见过的知识; - 如果你需要极度灵活的多租户策略切换:
我们在之前的实测中验证过的“推理层动态 Hook(Activation Steering)”依然是首选,它随时启闭,不污染任何物理文件。
大模型开始直接读写神经网络权重,并不意味着传统深度学习在一夜之间被淘汰。但它真真切切地为我们撕开了一道曙光:在算力垄断与显卡焦虑的高墙之下,用智能解构智能、用代码手术替代盲目重训的轻量工程时代,正在向我们走来。
💡 探索者互动探讨
你目前在本地部署 7B/8B 小模型时,被显存或微调折磨得最深的痛点是什么?
对于这种“不用训练显卡、直接由大模型做权重微创切除”的新路子,你在具体业务场景里能想到哪些可以直接落地的排险尝试?
欢迎在评论区一起交流探讨。
— 叩石寻径问路 · 工业认知与系统架构实录 —